Apprendre les Mathématiques et Statistiques pour la Data Analyse : Carnet de Bord
🛡️ Transparence : Cet article contient des liens affiliés vers DataCamp. L'inscription via ces liens me permet de toucher une commission sans surcoût pour vous. Je ne recommande que les outils testés et approuvés personnellement. En savoir plus →
💡 En Bref : Pourquoi apprendre les statistiques en data ?
- L'objectif : Traduire des données brutes en informations claires, fiables et actionnables.
- Le rôle métier : Agir comme un détecteur de mensonges pour contourner le hasard, les fausses corrélations et la déformation de la réalité.
- Le prérequis : Aucun diplôme en mathématiques n'est requis. L'essentiel est d'acquérir une "logique mathématique", les logiciels (comme Python ou Excel) se chargeant des calculs complexes à votre place.
Si vous souhaitez donner du sens aux chiffres et fiabiliser vos recommandations, apprendre les mathématiques et statistiques pour la data analyse est une étape incontournable. Loin des équations interminables, il s'agit avant tout d'adopter une logique implacable.
À quoi servent vraiment les Mathématiques et Statistiques au quotidien ?
En data analyse, face à des milliers de lignes de données brutes, l'humain est aveugle. Ce sont les outils mathématiques qui transforment ce chaos en indicateurs d'aide à la décision.
Voici les 4 piliers mathématiques de l'analyste :
- Les statistiques descriptives (Résumer la réalité) : Elles empêchent de fausser les données. Exemple : utiliser la médiane plutôt que la moyenne pour analyser des salaires évite d'être trompé par les valeurs extrêmes.
- Les probabilités (Valider les résultats) : Elles déterminent si un événement est statistiquement significatif ou simplement dû au hasard (ex. : une hausse de 3 % des ventes après une campagne marketing).
- Corrélation vs Causalité (Trouver les coupables) : Mesurer la force des relations entre variables pour éviter les conclusions absurdes (ex. : les ventes de lunettes de soleil et les coups de soleil augmentent ensemble, mais l'un ne cause pas l'autre).
- La modélisation (Prédire l'avenir) : Estimer les trajectoires futures les plus logiques à partir des données historiques via des régressions linéaires.
⚠️ L'erreur de débutant à éviter absolument
L'erreur la plus courante est de se fier aveuglément à la moyenne sans observer la distribution réelle.
- Le cas pratique : Une entreprise compte 1 patron (1 million d'euros/an) et 9 employés (2 000 euros/mois).
- Le piège : La moyenne affiche 101 800 euros de salaire. C'est mathématiquement exact, mais analytiquement trompeur.
- Le réflexe : Toujours utiliser la médiane (ici 2 000 euros) pour raconter la véritable histoire au décideur.
Comment se former efficacement à ces disciplines ?
Option 1 : L'approche théorique (100% gratuit)
Pour une approche académique, la chaîne YouTube de Steve Brunton (pack de 35 vidéos) ou la formation condensée de la chaîne "Le Coin Stat" (cours de 3h30 sans coupure) sont d'excellentes ressources. Vous y aborderez la théorie, de la statistique fréquentiste à la modélisation bayésienne.
La limite : C'est un apprentissage passif. Vous devez configurer vous-même vos environnements (Jupyter/Anaconda) et chercher vos propres jeux de données pour pratiquer.
Option 2 : L'apprentissage par la pratique en Python (Ma recommandation)
Les mathématiques s'assimilent beaucoup mieux lorsqu'elles sont appliquées directement à du code. C'est pour cela que je recommande le cursus "Principes de la statistique en Python" sur DataCamp.
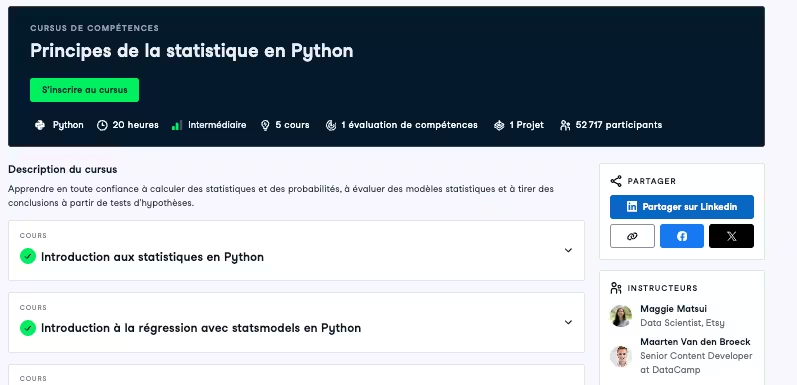
Ce parcours de 20 heures, suivi par plus de 52 700 apprenants, est redoutable pour passer de la théorie à la pratique sans friction :
- Zéro installation : Vous appliquez vos modèles de régression avec la librairie
statsmodelsdirectement dans le navigateur. - Apprentissage progressif : 5 cours interactifs allant des statistiques descriptives basiques jusqu'aux tests d'hypothèses avancés.
- Correction en temps réel : La plateforme corrige vos calculs de p-valeur ou d'échantillonnage instantanément.
Idée de projet Portfolio (Pour le CV)
Pour prouver à un recruteur que vous maîtrisez les statistiques, fuyez les datasets génériques. Appliquez ces concepts à des données qui ont un impact réel.
Réaliser une régression linéaire pour analyser l'impact d'une nutrition hyper-protéinée sur la progression du développement musculaire, ou tester des corrélations entre des macronutriments et des performances, prouve votre capacité à lier les mathématiques à des problématiques tangibles.
Documenter et héberger proprement cette démarche statistique sur un portfolio web personnel (via MkDocs et GitHub Pages par exemple) démontre une rigueur très recherchée sur le marché.
FAQ : Questions fréquentes
Combien de temps faut-il pour se former ?
Faut-il être un génie des maths ?
Quelle est la différence avec un Data Scientist ?
Et après ? (L'étape suivante)
Maintenant que votre base mathématique est solide, vous savez interroger une base (SQL) et valider la véracité de vos chiffres (Stats). Mais livrer un tableau rempli de valeurs p à un directeur marketing ne sert à rien : il faut rendre ces résultats visuels. L'étape suivante consiste à transformer vos conclusions en graphiques interactifs.