Apprendre le Machine Learning (ML) pour la Data Analyse : Carnet de bord & Ressources
💡 Transparence : Cet article contient des liens affiliés vers DataCamp. Si vous vous inscrivez via mon lien, je touche une commission, sans surcoût pour vous. Je ne recommande que les outils que j'utilise et valide au quotidien. En savoir plus →
Qu'est-ce que le Machine Learning en Data Analyse ?
Le Machine Learning (ML) en Data Analyse est l'utilisation d'algorithmes pré-entraînés pour enrichir et automatiser l'exploration de données. Contrairement au Data Scientist qui crée ces algorithmes, le Data Analyst exploite des modèles de ML existants pour prédire l'avenir, segmenter intelligemment des clients ou détecter automatiquement des anomalies.
Rejoignez plus de 180 000 participants sur ce cursus (Sans installation)
À quoi sert vraiment le ML au quotidien ?
Il n'est pas nécessaire d'être un génie des mathématiques pour utiliser cette technologie. En tant qu'analyste, notre rôle consiste à appliquer des modèles prêts à l'emploi pour anticiper l'avenir, et non à coder des algorithmes complexes de A à Z.
Concrètement, l'intelligence artificielle sert à 3 missions principales en analyse de données :
- L'anticipation (Prédiction) : Croiser des historiques complexes (ventes passées, météo, jours fériés) pour prévoir précisément l'avenir (ex : "nous vendrons 125 produits demain").
- Le regroupement (Clustering) : Segmenter automatiquement des profils clients dans de très grandes bases de données, sans croiser les variables à la main.
- La détection d'anomalies : Identifier instantanément une valeur aberrante, une fraude ou une ligne de vente suspecte qui s'écarte du comportement "normal".
💡 La bonne nouvelle : Vous n'avez pas toujours besoin de coder. Des algorithmes pré-entraînés sont directement accessibles sous forme de boutons dans des outils comme Excel (feuilles de prévision) ou Power BI.
Comment se former efficacement ?
Option 1 : L'approche système D (100% gratuit)
Une solide remise à niveau en algèbre linéaire est indispensable pour comprendre le traitement des données par les modèles.
- La ressource : La formation gratuite de Kylie Ying (via freeCodeCamp).
- Le programme : Théorie, puis implémentation d'algorithmes classiques (KNN, Naïve Bayes, Régression Logistique) et de Deep Learning (TensorFlow) dans Google Colab.
La limite (Friction élevée) : L'apprentissage vidéo est passif. Vous perdez énormément de temps à configurer votre environnement, formater les datasets et mettre la vidéo en pause pour retaper le code.
Option 2 : L'apprentissage par la pratique (Ma recommandation)
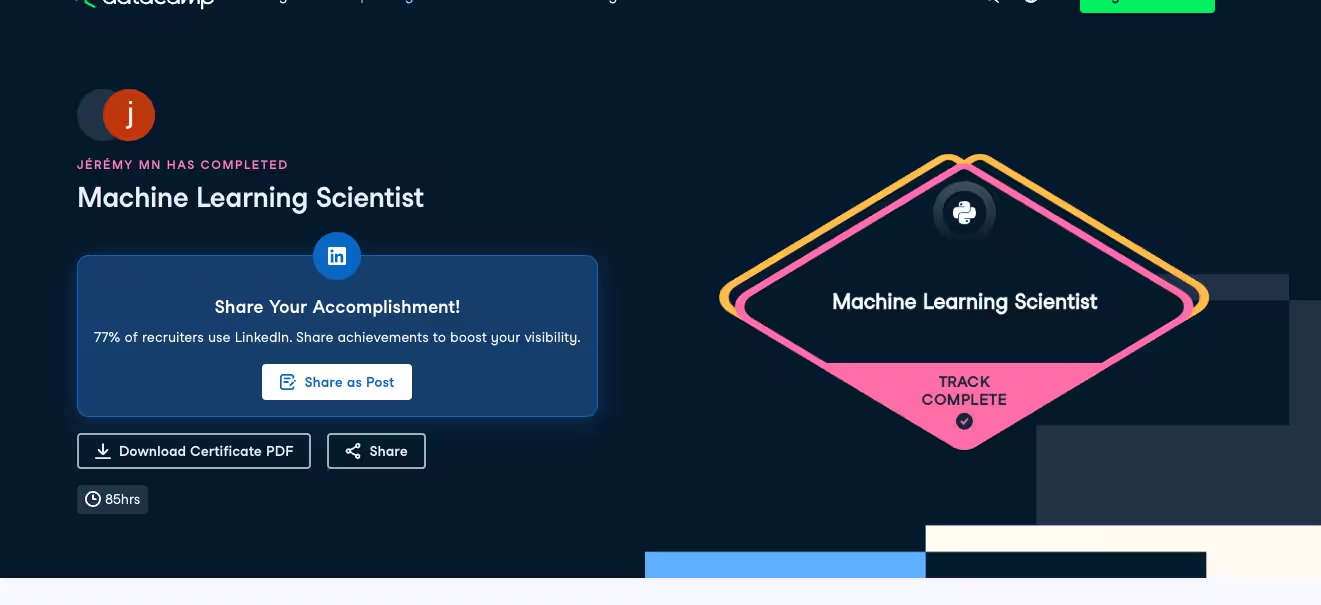
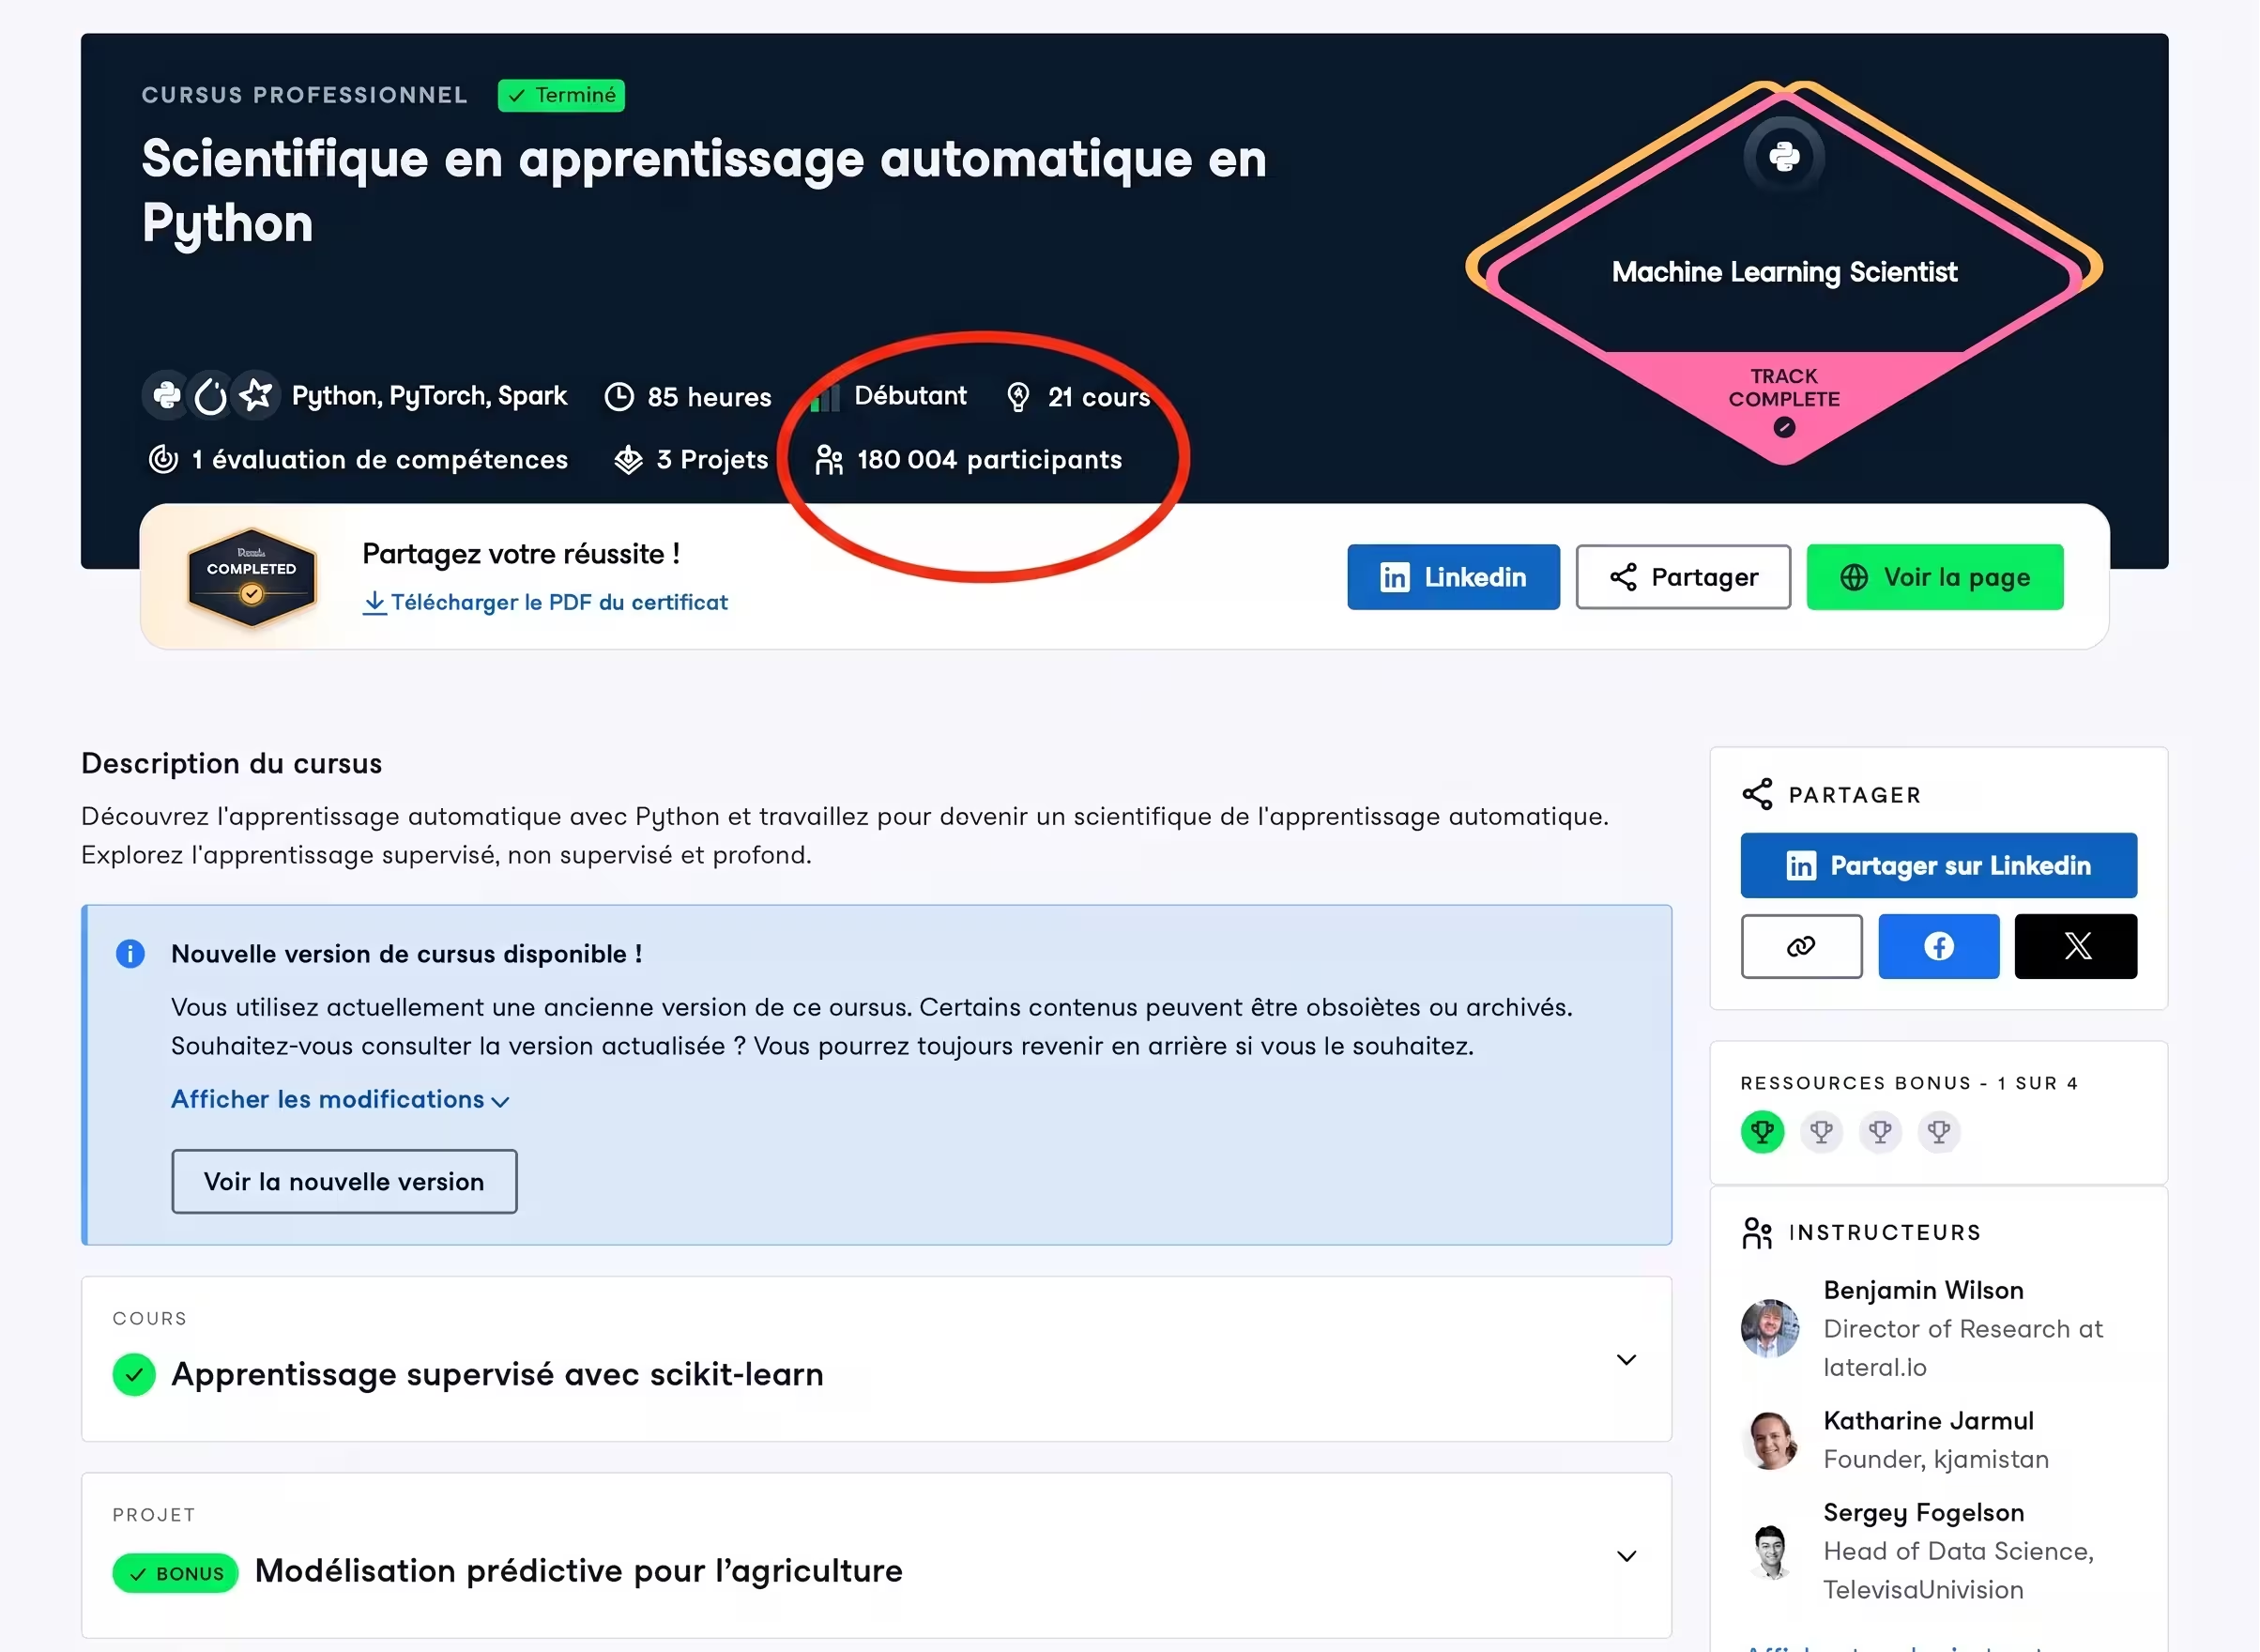
Pour progresser rapidement sans friction technique, le cursus "Machine Learning Scientist avec Python" de DataCamp est la ressource la plus complète.
- Le format : Un parcours professionnel intensif de 85 heures, réalisable à votre rythme.
- Le contenu : 21 cours et 3 projets pour maîtriser tout l'écosystème technique (Python, PyTorch, Spark).
- L'encadrement : Des cours conçus par des experts de l'industrie (Benjamin Wilson, Katharine Jarmul, Sergey Fogelson).
Ce cursus rassemble aujourd'hui plus de 180 000 apprenants à travers le monde :

Pourquoi cette méthode surpasse les tutoriels classiques :
- Zéro Friction : Aucune configuration ou installation requise. L'entraînement des modèles (XGBoost, K-Means, PySpark) se fait directement dans votre navigateur.
- Micro-apprentissage : La théorie est condensée, la pratique est immédiate. Vous appliquez les concepts d'apprentissage supervisé avec
scikit-learnsur des jeux de données réels. - Correction en temps réel : La plateforme isole et vous indique instantanément l'erreur dans votre code Python (que ce soit sur de la réduction de dimension ou du NLP avec
spaCy). - Gamification : Vous accumulez de l'XP à chaque étape. Les projets finaux (modélisation prédictive agricole, clustering de manchots) maintiennent l'engagement au maximum.
L'erreur de débutant absolue
⚠️ Avertissement : Vouloir utiliser immédiatement des algorithmes de prédiction complexes comme XGBoost est une erreur fréquente. L'étape la plus cruciale est le prétraitement des données (preprocessing) et le feature engineering.
Un algorithme n'est performant que si les données qu'on lui fournit sont de qualité. Votre plan d'action avant tout entraînement :
- Nettoyez vos variables brutes.
- Normalisez les données.
- Traitez les valeurs manquantes.
- Créez des caractéristiques (features) pertinentes.
C'est cette préparation minutieuse de la donnée qui garantit la précision finale de vos résultats.
Idée de projet Portfolio (Pour le CV)
Construire des projets concrets est le meilleur levier pour prouver votre valeur technique et décrocher un premier emploi dans la Data. (Je construis d'ailleurs actuellement mon propre portfolio avec Python, MkDocs, Miniconda et GitHub Pages pour documenter proprement mes travaux).
La meilleure source de données : Kaggle est le terrain de jeu absolu. Cette plateforme abrite des milliers de bases de données réelles et gratuites (les "Datasets").
L'astuce de sélection : Choisissez des sujets qui vous passionnent plutôt que des données fictives ennuyeuses. De mon côté, j'utilise des fichiers CSV axés sur le développement musculaire ou la composition des repas healthy hyper-protéinés. E-commerce, santé, jeux vidéo : importez vos données brutes, nettoyez-les et appliquez vos modèles.
Votre premier défi (Le rite de passage) :
Rendez-vous dans la section "Competitions" de Kaggle et lancez-vous sur Titanic: Machine Learning from Disaster.
- La mission : Prédire la survie des passagers en fonction de leurs variables (âge, sexe, classe de billet).
- Le but : Valider concrètement vos acquis de base.
Questions fréquentes (FAQ)
Combien de temps faut-il pour se former ?
Faut-il être un expert en mathématiques pour débuter ?
Cette technologie est-elle vraiment utile pour un analyste ?
Où puis-je trouver des données pour m'entraîner ?
Et après ? (L'ultime étape)
Maîtriser le Machine Learning représente la cerise sur le gâteau. En validant cette compétence, vous touchez à la fin de votre apprentissage technique. Le piège principal à ce stade est de rester bloqué dans la boucle des tutoriels. Votre objectif ne doit plus être d'apprendre un énième outil, mais de prouver votre valeur sur le marché.